
 AI駆動開発

AI駆動開発が急速に広がるにつれて、多くの開発組織で新たな課題として浮上しているのが、AIコストをどうマネジメントするかという問題です。
アカウント課金から従量課金への移行が進み、AIコストは使った分だけ積み上がる変動費になりつつあります。一方で、コストを抑えようとトークン消費を闇雲に絞れば、AI活用そのものが停滞しかねません。
使った分のトークンは、本当に価値に見合っているのかという問いに向き合うための考え方がトークンマネジメントです。
本記事のサマリー
- トークンマネジメントとは:AI駆動開発における生産性を保ちながら、トークンの消費とコストを組織として管理・最適化する考え方。トークン消費量そのものを目的化してしまう「トークンマキシング」とは、主語とレベル感が異なる別の視点の概念。
- AIコストが重要になっている背景:アカウント課金から従量課金への移行により、AIコストは使った分だけ積み上がる変動費になりつつある。UberやAmazonの事例が示す通り、利用量そのものを競う仕組みは、成果とずれた行動を助長するリスクがある。
- 基本的な進め方:AIコスト総額を「成果数×成果あたりのトークン量×トークンあたりの単価」に分解し、観測基盤を整えたうえで、まず生産量を最大化してから消費効率の改善、費用の低減へと順に進める。
- 具体的な打ち手と自社事例:生産量・消費効率・費用それぞれのアプローチにおける具体的な打ち手と、Findy自身が取り組んだ改善事例を紹介。
トークンマネジメントとは?
トークンマネジメントとは、AI駆動開発における生産性を保ちながら、トークンの消費とコストを組織として管理・最適化する考え方です。プロンプトキャッシュの活用やモデルの切り替えといった技術的なコスト削減手法そのものではなく、AIコストと組織としてどう向き合うかという視点が本質にあります。
本記事では、AIコーディングツールの活用が広がるソフトウェア開発組織を想定し、CTO・VPoE・EMなどのマネジメント層が、開発生産性とAIコストをどのように両立していくかという視点から、具体的な進め方を解説します。
ここでいうトークンとは、AIがテキストを処理する際に扱う最小単位です。生成AIのAPIは入力と出力それぞれのトークン量に応じて課金される仕組みになっており、やり取りが増えるほど費用も積み上がっていきます。AIコーディングエージェントの活用が広がるにつれ、トークンの消費コストは、エンジニア1人あたりのコストの中で無視できない割合を占め始めています。
また、トークンマネジメントを語るうえで欠かせないのが、トークンマキシングという言葉です。名前は似ていても、指しているものは大きく異なります。
「トークンマキシング」とは何か
トークンマキシングとは、ビジネス成果ではなくトークン消費量そのものを目的化し、最大化してしまう利用行動を指す言葉です。
「token」に「極限まで追求する」を意味する英語のネットスラング「maxxing」が付いた造語で、2026年3月、ニューヨーク・タイムズのケビン・ルーズ氏の報道をきっかけに広まりました。※1 「利用量が価値の代用指標になってしまっている」という批判を含む言葉である一方、AI活用に前のめりな姿勢を指す自称としても使われています。
両者は「トークンを使うか、絞るか」という対立概念ではありません。「個人の利用行動(マキシング)」と「組織のガバナンス設計(マネジメント)」という、視点とレイヤーが異なる概念として捉えるのが本質です。
| トークンマキシング | トークンマネジメント | |
|---|---|---|
| 主体 | 個人のエンジニア、チーム、AIエージェント | 経営層、開発組織のマネジメント層 |
| 着眼点 | トークン消費量の最大化(利用量そのものを重視) | コスト削減ではなく、成果あたりのコストが妥当かどうかを見ること |
| 目的・性質 | AIをとにかく使おうとする個人の前のめりな利用行動 | AIコストを変動費として管理し、投資対効果(ROI)を説明可能にする組織のガバナンス設計 |
また、トークンマキシングは、どこには積極的にコストをかけ、どこでは抑えるべきかを組織が学習するための方法という側面もあります。個人の試行錯誤を組織が観測し、統制のルールへと落とし込んでいく、一続きのプロセスとして捉えると理解しやすくなります。
マイクロソフトCEOのサティア・ナデラ氏は、ニューヨーク・タイムズのポッドキャスト「Hard Fork」でのインタビューで、「AIによる10%のGDP成長」という目標に言及しています。この目標について「生産性向上の限界費用が、トークンの限界費用と一致しなければならない。それはマネジメントの規律である」としたうえで、「誰もがバイブコーディングとトークンマキシングをしている状態では、10%成長は達成できない」と警告しました。※2 この規律こそが、トークンマネジメントであるといえます。
トークンマネジメントが重要になっている理由
トークンマネジメントが重要視されはじめた背景には、下記のような3つの市況の変化があると考えられます。
料金体系の変化:AIコストは「変動費」になった
AIコーディングは、月額固定のアカウント課金から、使った分だけ支払う従量課金へと軸足を移しつつあります。その象徴的な事例がGitHub Copilotの料金体系の変更です。GitHub Copilotは2026年6月1日、Premium Requestsベースの課金から、実際のトークン消費量に応じた「GitHub AI Credits」へ移行しました。基本的なコード補完は引き続きクレジットを消費しませんが、ChatやエージェントモードはAI Creditsを消費するため、利用量に応じて追加コストが発生する仕組みに変わっています。※3
従量課金化により、AIのコストは人件費のような固定費ではなく、使用量に応じて変動する変動費になります。
また、現在のサブスクリプション料金についても、留意しておきたい点があります。今後、AIベンダーが投資フェーズから収益化フェーズに移った場合、これまで比較的抑えられてきた価格が従量課金への移行や値上げといった形で将来的に見直される可能性があります。
AIコストの増大と拡大するトークン消費
コーディングエージェントの活用が組織で広がるにつれて、エンジニア1人あたりのトークン消費コストは上昇しつづけることになります。LayerXの福島良典氏も指摘するように、このような状況になるとエンジニアを1人雇うコストを、給与だけでなく給与とAIトークン費のセットで捉える必要が出てきます。※4 そのため、人件費に並ぶ、新しいコスト科目としての認識が求められる段階に入っているといえます。
また、AIコーディングエージェントや高度なAIモデル(OpusやFableなど)の登場によって、これまで扱えなかった規模の複雑な推論や、複数ファイル・大規模コードベースの横断的な読み込みが可能になったことで、消費されるトークンの絶対量も増加しています。
成果・費用対効果を問われるフェーズへ
企業のAI活用が試用フェーズだった時期にはAIをとにかく使うことが競争優位だと語られ、AIベンダー側も定額サブスクリプションの料金体系によって利用量の拡大を後押ししてきました。言ってみれば、市況全体がトークンマキシング的なフェーズだったといえます。
しかし、2026年に入って、本記事の後半で紹介するUberの事例や前章で触れたナデラ氏の発言などから、AI活用の費用対効果を問う機運が強まるようになり、トークンをどれだけ使ったかではなく、そのトークンがどれだけの生産量や成果を生んだのかを説明できるかどうかが重要視されるようになりました。
トークンマキシングの失敗事例
トークン消費量そのものを競う仕組みが、成果と結びつかない利用を助長し、結果的に方針転換につながった海外企業の事例があります。ここでは、UberとAmazonという2つの事例を取り上げます。
Uber:AIツールの採用率が大幅上昇した一方でAIコーディングの年間予算を4ヶ月で使い切る
Uberは社内に、Claude Codeの利用量を競わせるリーダーボードを設置し、週あたりの利用目標も設定していました。その結果、AIツールの採用率は32%から84%へ上昇した一方で、2026年に確保していたAIコーディング予算を、わずか4ヶ月で使い切ってしまいました。
同社はその後、ツールごとの利用上限を設定する対応に転換しました。また、同社COOのアンドリュー・マクドナルド氏は、ポッドキャストやFortune誌の取材で、トークン消費とそれに伴うコストを人件費と並べて議論する必要性に言及しています。※5 ※6
この事例が示しているのは、利用量そのものをKPI化する仕組みが、成果と紐づかないままトークン消費だけを加速させてしまうというリスクです。
Amazon:リーダーボードの順位を上げるためのトークン消費が横行
Amazon社内では、「KiroRank」と呼ばれるAIトークンの利用量を可視化するリーダーボードが一部の従業員によって非公式に作成されていましたが、一部の従業員が順位を上げるために、必ずしも問題解決につながらないタスクでAIを利用する状況が生じていたため、その後、このリーダーボードは廃止されることとなりました。 ※7
同社の上級副社長デイブ・トレッドウェル氏は、AIを使うこと自体を目的にするのではなく、顧客やビジネス上の課題解決、イノベーションのために活用するよう社員に伝えるとともに、AIツールの利用方法や利用状況の追跡方法は各チームの裁量に委ねられる形になりました。※7
この事例は、利用量そのものを評価指標にすることがいかに目的と手段の逆転を招きやすいかということを示しています。指標が目標に変わった瞬間、その指標は意味を失うという、いわゆる「グッドハートの法則」が働いた形です。
これら2社の事例からの教訓は、AIを使った量を評価指標にすると、成果に結びつかない利用まで助長されてしまい、組織にとっての望ましい結果にならないということです。
| 行ったこと | 結果として起こったこと・その教訓 | |
|---|---|---|
| Uber | 社内にリーダーボードを設置し、Claude Codeの利用量を競わせた。週あたりの利用目標も設定した | AIツールの採用率は32%から84%へ上昇した一方、2026年のAIコーディング予算を4ヶ月で使い切った。その後、ツールごとの利用上限を設定した |
| Amazon | 一部従業員が非公式に、AIトークンの利用量を可視化するリーダーボードを作成した | 順位を上げるためだけのタスクが生じたため、リーダーボードを廃止した。AIツールの利用方法や利用状況の追跡方法は各チームの裁量に委ねられている |
トークンマネジメントの基本的な進め方
ここまで、トークンマネジメントが重要になっている背景とトークンマキシングが引き起こした失敗事例を見てきましたが、今後は「AIを使った量」から「使った量が生んだ成果や効率」へと評価軸を変えていく必要があります。ここからは、このような観点を踏まえたトークンマネジメントの進め方について見ていきます。
AIコストの総額は、成果数×成果あたりのトークン量×トークンあたりの単価という3つの要素の掛け算で決まります。

トークンマネジメントの目的はコスト総額を最小化することではなく、成果あたりのコストを説明できる水準に保ちながら成果を最大化することにあります。そのため、まずは成果そのものを増やす「生産量を最大化する」というアプローチから着手するのが有効です。
| アプローチ | 改善対象 | 方向性 |
|---|---|---|
| 生産量を最大化する | 成果数 | 成果そのものを増やす |
| 消費効率を改善する | 成果あたりのトークン量 | 同じ成果を、より少ないトークンで出す |
| 費用を低減する | トークン単価と総額 | 1トークンあたりの価格を下げ、総額に上限を設ける |
トークンマネジメントの基本方針
トークンマネジメントを実践するにあたって、効率化から着手しないことが重要です。アウトプットが十分に伸びていない段階でコスト削減を優先すると、組織ではAIの利用抑制の方向に傾きがちになり結果的にAI活用自体も細ってしまうリスクがあります。そのため、まず生産量を伸ばし、それが安定してから消費効率の改善や費用の低減へと進む順序を守るようにするのが望ましいです。
また、難易度の高いタスクや重要な意思決定では、あえてトークンを惜しまず使う判断も必要です。一方、定型的で反復的なタスクや即時性が求められない処理では、コストを抑える判断が適しています。ナデラ氏も「最先端ではない問題にフロンティアモデルを使ってはいけない」と述べているように※2、問題の難易度と使うモデルの水準を一致させ、工程やタスクの性質に応じて意識的に使い分けることをおすすめします。
観測基盤を最初に整える
上記の3つのアプローチのいずれも、着手にあたって現状が見えていなければ正しい評価ができません。そのため、観測の基盤はトークンマネジメントにおける共通の土台として、最初に整えておく必要があります。
観測の基盤を整備したうえで見るべき観点は、次の3点です。
- 開発フローのどの工程でAIが活用され、どこで詰まっているか
- 作業タイプ(機能開発・テスト・リファクタなど)ごとのAI活用状況
- 誰が、どのモデルで、どのタスクに、どれだけトークンを使っているか
そのうえで、アプローチごとに追っていく具体的な指標を決めます。
| アプローチ | 改善対象 | 主に追う指標 |
|---|---|---|
| 生産量を最大化する | 成果数 | スループット(PR作成数)、リードタイム |
| 消費効率を改善する | 成果あたりのトークン量・費用 | トークン/PR、コスト/PR |
| 費用を低減する | トークン単価と総額 | 月次総額、利用上限の消化率 |
生産量を最大化する打ち手
まずは生産量を伸ばすための打ち手を見ていきます。
AI活用工程の拡大
生産量とは実装だけを指すものではありません。実装工程でAI活用が進み、コーディングそのものが速くなったとしても、その後工程が詰まれば組織全体のアウトプットは変わらないからです。実装の高速化によってレビューがボトルネックになっている場合は、次にレビュー工程へAI活用を広げます。レビュー工程でAIを活用するためのSkillやルールを整備し、さらに仕様整理・テスト・リファクタなど、ボトルネックとなっている工程へAI活用を広げていきます。
並列実行・自律実行環境の整備
生産量はスループットで決まるため、1回の対話を速くするより、同時に走らせる本数を増やすほうが効果が大きい場合があります。複数のエージェントを並行して動かす運用、CI上でエージェントを実行する仕組み、そのために必要なテスト環境・シードデータ・権限設計を整えます。
ただし、この打ち手は、実装後のボトルネックとなる工程でも処理能力を高めていることが前提になります。そこを飛ばして並列化だけを進めると、ボトルネックがかえって悪化してしまいます。
AIが着手できる粒度へのタスク分解
AIに渡す指示が曖昧なほど、手戻りが増えてしまい生産量は落ちます。そのため、着手可能な粒度まで分解し受け入れ条件を明示する運用を行います。また、それらが特定メンバーの個人技に依存しない形で標準化していきます。
CI/CDの自動化・品質ゲート整備
最後に欠かせないのが、テストカバレッジやLint、静的アプリケーションセキュリティテスト(SAST)といった、CI/CD上の品質ゲートの整備です。生成量が増えても品質を担保できる基盤があってこそ、AI活用は安心して広げられます。品質ゲートが整っていない状態でAI活用を進めると、生成されたコードに含まれる不具合が検出されないままマージされてしまうリスクが高まってしまいます。
【自社事例】メトリクスの可視化からレビューのボトルネックを解消
Findyでは、AI導入前後の数値をFindy Team+とFindy AI+で可視化し、そこから仮説を立てて改善アクションを実施した事例があります。
AI導入前後の各種メトリクスを比較したところ、1人あたりのPR作成数はほぼ横ばいでした。変更のリードタイムを見ると、コミットからPR作成までは若干速くなっていた一方で、PRのオープンからレビューを経て最終的にアプルーブをもらうまでの時間は、AI導入後のほうが導入前より50%程度悪化していました。
レビュー工程のメトリクスを深掘りしたところ、PRに対する平均コメント数が30%程度増えていることが分かりました。さらにコメントの中身を分類すると、AIが書いたコードを十分に理解しきらないままレビュー依頼を出しているケースが多く、半数以上が作成者自身のセルフレビューで防げる内容でした。レビュー依頼前のセルフレビュー不足が、生産性のボトルネックになっていたのです。
そこで、複数の観点を同時にチェックするセルフレビュー用のSkillを用意し、PR作成のタイミングで強制的に実行されるようにしました。運用に乗るにつれてSkillの利用率が上昇し、レビューからアプルーブまでの平均時間は10%程度速くなりました。セルフレビューの仕組み化によってボトルネックが解消し、実装が速くなった効果がフロー全体の高速化に寄与した形です。※8 ※9 ※10
消費効率を改善する打ち手
生産量が安定したら、次に成果あたりの消費効率を見ていきます。ここでは、「トークン/PR」と「コスト/PR」を分けて捉えていきます。「トークン/PR」は、総トークン消費量をPR数で割った指標で、1件の成果を生み出すためにどれだけのトークンを消費したかを示します。一方、「コスト/PR」は、AI利用にかかった費用をPR数で割った指標で、利用モデルごとの単価まで含めた金額ベースの効率を示します。
トークンマネジメントの基本方針でも述べた通り、コストの総額だけを追いかけると、組織ではAIの利用抑制の方向に傾きがちになります。ですが、成果あたりのトークン量と費用を分けて見ることで、AI活用を維持しながらどこに改善余地があるのかを構造的に捉えることができるようになります。
コンテキストの設計
コンテキスト、つまりAIに毎回渡す前提情報が整備されていないリポジトリでは、指示のたびにゼロから組み立てる必要があり、トークン消費が膨らみます。また逆に不要なファイルまで毎回読み込ませても無駄にトークンを消費してしまいます。コンテキストの「足りない」と「多すぎる」の両方が効率を落としてしまう点には注意が必要です。
このコンテキストの過不足は、Claude APIのコンテキスト管理機能でも調整できます。古いツール結果などを選択的にクリアするcontext editingや長い会話の古いコンテキストを要約して置き換えるcompactionを活用し、必要な情報を保ちながらコンテキストを肥大化させない運用が有効です。※14
Skill・コマンドの標準化
定型的な作業を毎回対話で組み立てる運用では、やり取りの往復が増え、同じアウトプットを得るためのトークン消費が膨らみやすくなります。対話を重ねるたびに、それまでの会話履歴もコンテキストとして扱われるためです。繰り返す作業はSkillやコマンドとして標準化し、対話の往復を減らすことで、トークン消費を抑えやすくします。
出力量とセッションの制御
出力トークンにも入力と同様に課金が発生します。そのため、簡潔な出力を促すプロンプト設計を行うことで無駄な出力を防ぐことができます。また、会話を延々と続けるとそのたびに履歴を読み直すことになり、トークンの消費が膨らみやすくなります。そのため、適切なタイミングで区切る、要約するといった運用をあらかじめ決めておくことが有効です。
再試行ループの抑制
テストが通らないまま再試行を繰り返すループはトークンの浪費につながりやすい要因です。システム的な安全弁として、試行回数の上限や異常検知時のサーキットブレーカー(強制遮断)を組み込みます。あわせて、行き詰まった際に人へ引き渡す基準も定めておくとよいでしょう。
属人化を防ぐためのナレッジ横展開
AI活用が進んでいるメンバーと活用余地があるメンバーとでは、AI活用の仕方そのものに違いがある場合があります。そのため、個別のヒアリングや報告会、ドキュメント整備などの情報共有を通じてナレッジを形式知化して組織全体に展開することで、生産量とトークン消費効率を両立させるヒントが得られます。
【自社事例】コスト/PRの比較から見えたチーム間の差
Findyでも、Findy AI+のセッションログを使ってチーム・メンバー単位のコスト/PRを比較したところ、チームによって最大4倍以上の差が見られました。同じ1件のPRを生み出すためにかかっているAI利用費用に、これだけの開きがあるということです。
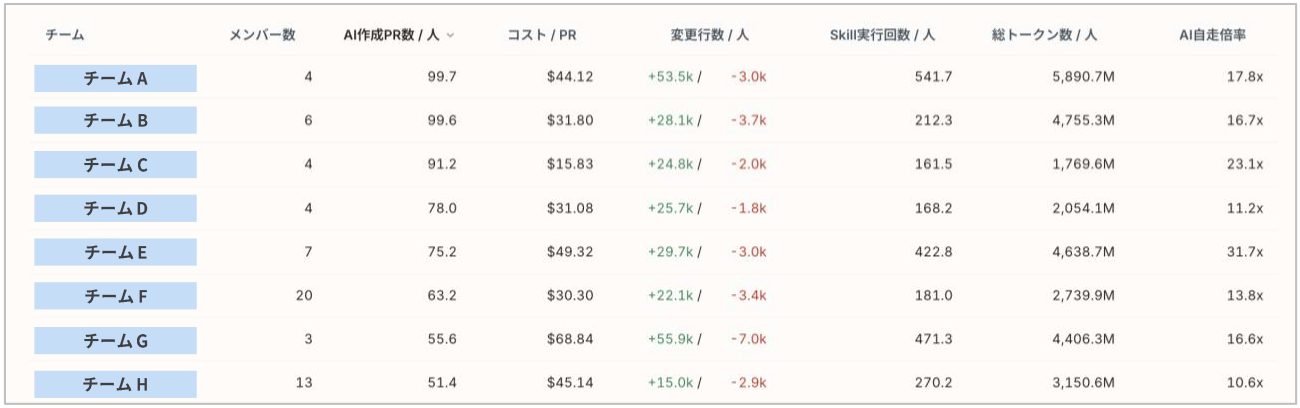
あわせて、「Skill実行回数/人」と「総トークン数/人」には相関が見られました。Skillを多く使っているチームほど自律的にAIを動かせている分、トークン利用量そのものは多くなっている可能性が高いという見立てです。この結果を踏まえ、チームやメンバー間の差異を分析し、消費効率の高い活用方法を横展開する取り組みを進めました。
費用を低減する打ち手
生産量の増加と消費効率の改善が出来た段階で、いよいよ費用そのものを下げる打ち手に着手します。
LLM・モデルの使い分け
タスクの難易度や品質要件に応じて、使うモデルを切り替えることが基本になります。例えば、メインの処理にはSonnet、サブエージェントや比較的単純なバックグラウンド処理にはHaikuを利用する、といった役割分担が考えられます。ただし、最適なモデルはタスクや品質要件によって異なるため、自社の評価結果をもとに使い分けます。Claudeでは、エフォート(effort)をlow/medium/high/xhigh/maxの段階で調整し、同じモデルでも品質・速度・トークン消費のバランスを変えられます。デフォルト値や推奨設定はモデルによって異なるため、利用モデルの仕様と自社の評価結果をもとに調整します。※13
ただし、安価なモデルが必ずしもトータルコストも安いとは限りません。能力の低いモデルで3回試行錯誤するよりも、上位モデルで1回で完了するほうが安く済む場面もあります。そのため、費用対効果の判断は「1リクエストの単価」ではなく「完了した成果あたりのコスト」で行うべきです。※11 ※12
プロンプトキャッシュの活用
前提情報をキャッシュすると、繰り返し同じコンテキストを利用する際の読み出しコストを下げられます。キャッシュの書き込みと読み出しの料金はモデルによって異なり、主要モデルではキャッシュ読み出しが通常の入力料金の2.5〜10%に設定されています。同じ前提情報を繰り返し参照する処理ほど効果を得やすいため、利用するモデルの最新料金を確認したうえで活用します。※15
即時性が不要な処理のバッチ化
即時応答が不要な処理では、Batch APIの利用も選択肢になります。AnthropicのMessage Batches APIでは、すべての使用量が標準API料金の50%で課金されます。夜間処理や大量の非同期タスクなど、即時性を必要としない処理で活用できます。※16
利用上限・アラートの整備
チーム・プロジェクト単位で月次利用上限を設定し、閾値到達時にアラートを通知します。到達時の挙動は、安価なモデルへの自動フォールバックにするか、ハードブロックにするかなどをあらかじめ設計しておきます。
課金プランの選択
定額サブスクリプションとAPI従量課金のどちらが安いかは、組織での利用状況によって変わります。人数やトークン消費量などを観測したうえで契約形態を見直すことが、個々での技術的な打ち手よりも費用低減の効果が大きい場合もあります。
Findyのツールでトークンマネジメントを進める
ここまで述べてきた、生産量を伸ばす、消費効率を高める、費用を下げるという打ち手は、いずれも現状が可視化されていなければ実行に移せません。Findyでは、生産性の可視化をFindy Team+、AI活用とトークン効率の可視化をFindy AI+で提供しています。
Findy Team+で生産量を可視化する
Findy Team+は、実装からレビュー、テストまで、開発フロー全体のリードタイムやスループットを可視化するプロダクトです。どの工程がボトルネックになっているかを特定し、AI導入前後の生産量の変化を定量的に把握できます。まず生産量を伸ばすというフェーズにおいて、現状把握の土台になります。

Findy AI+でAI活用とトークン効率を可視化する
Findy AI+は、誰がどのモデルに、どのタスクで、どれだけのトークンを使っているかを可視化します。コスト/PRのような金額ベースの成果あたり効率を測定し、ハイパフォーマーと伸び代のあるメンバーの活用状況の違いを比較できます。消費効率を高め、費用を下げていくフェーズで、打ち手の効果を検証する際に活用できます。

FAQ:トークンマネジメントについてよくある質問
Q1. トークンマネジメントとは何ですか?
AI駆動開発における生産性を保ちながら、トークンの消費とコストを組織として管理・最適化する考え方です。プロンプトキャッシュの活用やモデルの切り替えといった技術的な手法そのものではなく、AIコストと組織としてどう向き合うかという視点が本質にあります。
Q2. トークンマキシングとの違いは何ですか?
トークンマキシングは、ビジネス成果ではなくトークン消費量そのものを目的化してしまう利用行動を指し、個人のエンジニアやチームが主語になります。トークンマネジメントは、AIを使わせる側、つまり経営や組織のガバナンスを主語とする言葉です。対になる概念ではなく、主語とレベル感が異なる別の視点の概念だと捉えると理解しやすくなります。
Q3. なぜ最初からコスト削減を優先してはいけないのですか?
アウトプットが十分に伸びていない段階でコスト削減を優先すると、組織の力学がAIを使わないことに最適化されてしまうためです。まず生産量を伸ばし、それが安定してから効率化に進むという順序が重要になります。
Q4. トークンマネジメントを始めるには何から着手すればよいですか?
まずは、誰がどの工程でどれだけAIを活用し、どこで詰まっているかを可視化することが出発点になります。生産量が安定した後に、トークン/PRで成果あたりのトークン消費量を、コスト/PRで金額ベースの費用効率を測定するフェーズへ進みます。
Q5. AIコストが「変動費」になるとはどういうことですか?
AIコーディングがアカウント課金から従量課金へ移行し、費用が使った量に応じて変動する、新しいコスト科目になるということです。組織で利用枠を共有する場合、上限を設定していなければ、一部の利用者が枠を使い切ってしまうリスクがあります。
Q6. プロンプトキャッシュやバッチ処理でコストはどれくらい下がりますか?
プロンプトキャッシュでは、キャッシュ済みコンテキストの読み出し料金が通常の入力料金より低く設定されており、主要モデルでは通常入力料金の2.5〜10%です。AnthropicのMessage Batches APIでは、すべての使用量が標準API料金の50%で課金されます。キャッシュ料金はモデルによって異なるため、最新の料金体系を確認したうえで使い分けることが重要です。※15 ※16
参考資料・関連リンク
- ※1 Kevin Roose「More! More! More! Tech Workers Max Out Their A.I. Use」(ニューヨーク・タイムズ、2026年3月20日)
- ※2 Satya Nadella on A.I. Jobs: Humans Will Do the ‘Glue Work’(ニューヨーク・タイムズ ポッドキャスト「Hard Fork」/YouTube、2026年6月)
- ※3 GitHub Copilot、6月1日より従量課金モデルへ移行(ITmedia NEWS、2026年4月28日)
- ※4 トークンマキシングからトークンマネジメントへ(LayerX note、福島良典氏)
- ※5 Uber’s swerve on gas prices, hotels & a driverless future, with Andrew Macdonald(Rapid Response、2026年5月22日)
- ※6 Uber COO on AI spending and tokens(Fortune、2026年5月26日)
- ※7 Amazonがトークン消費を競うランキングボードを廃止…「トークン消費を目的に、AIを使わないで」(Business Insider Japan、2026年6月1日)
- ※8 可視化と改善を合わせて考える―メトリクスを起点にAI推進を成果へ繋げる回し方(Findy Tech Blog、2026年7月1日)
- ※9 生成AI導入の「期待外れ」を乗り越える―開発フロー改革が目指す、真の組織変革(SpeakerDeck)
- ※10 Findyの爆速開発を支えるセルフレビュー自動化の仕組み(Findy Tech Blog、2026年3月13日)
- ※11 適切なモデルの選択(Anthropic公式ドキュメント)
- ※12 モデル概要(Anthropic公式ドキュメント)
- ※13 Effort(Anthropic公式ドキュメント)
- ※14 コンテキスト編集(Anthropic公式ドキュメント)
- ※15 プロンプトキャッシング(Anthropic公式ドキュメント)
- ※16 バッチ処理(Anthropic公式ドキュメント)

AI時代の開発資本プラットフォーム


